?现在是坏的吗?
那四个外国坏了
我草!!!!微积分怎么这么难啊..............
草了,25分的积分题,我只会前6分
不是,有个积分的答案是arcsin,我都不知道arcsin都导数是啥,我咋可能积出arcsin…
你在训练的是哪个,训练出来做啥 (
还有个超级长串的函数求导,里面有个cosh,我不知道cosh的导是什么
有公式?我记得
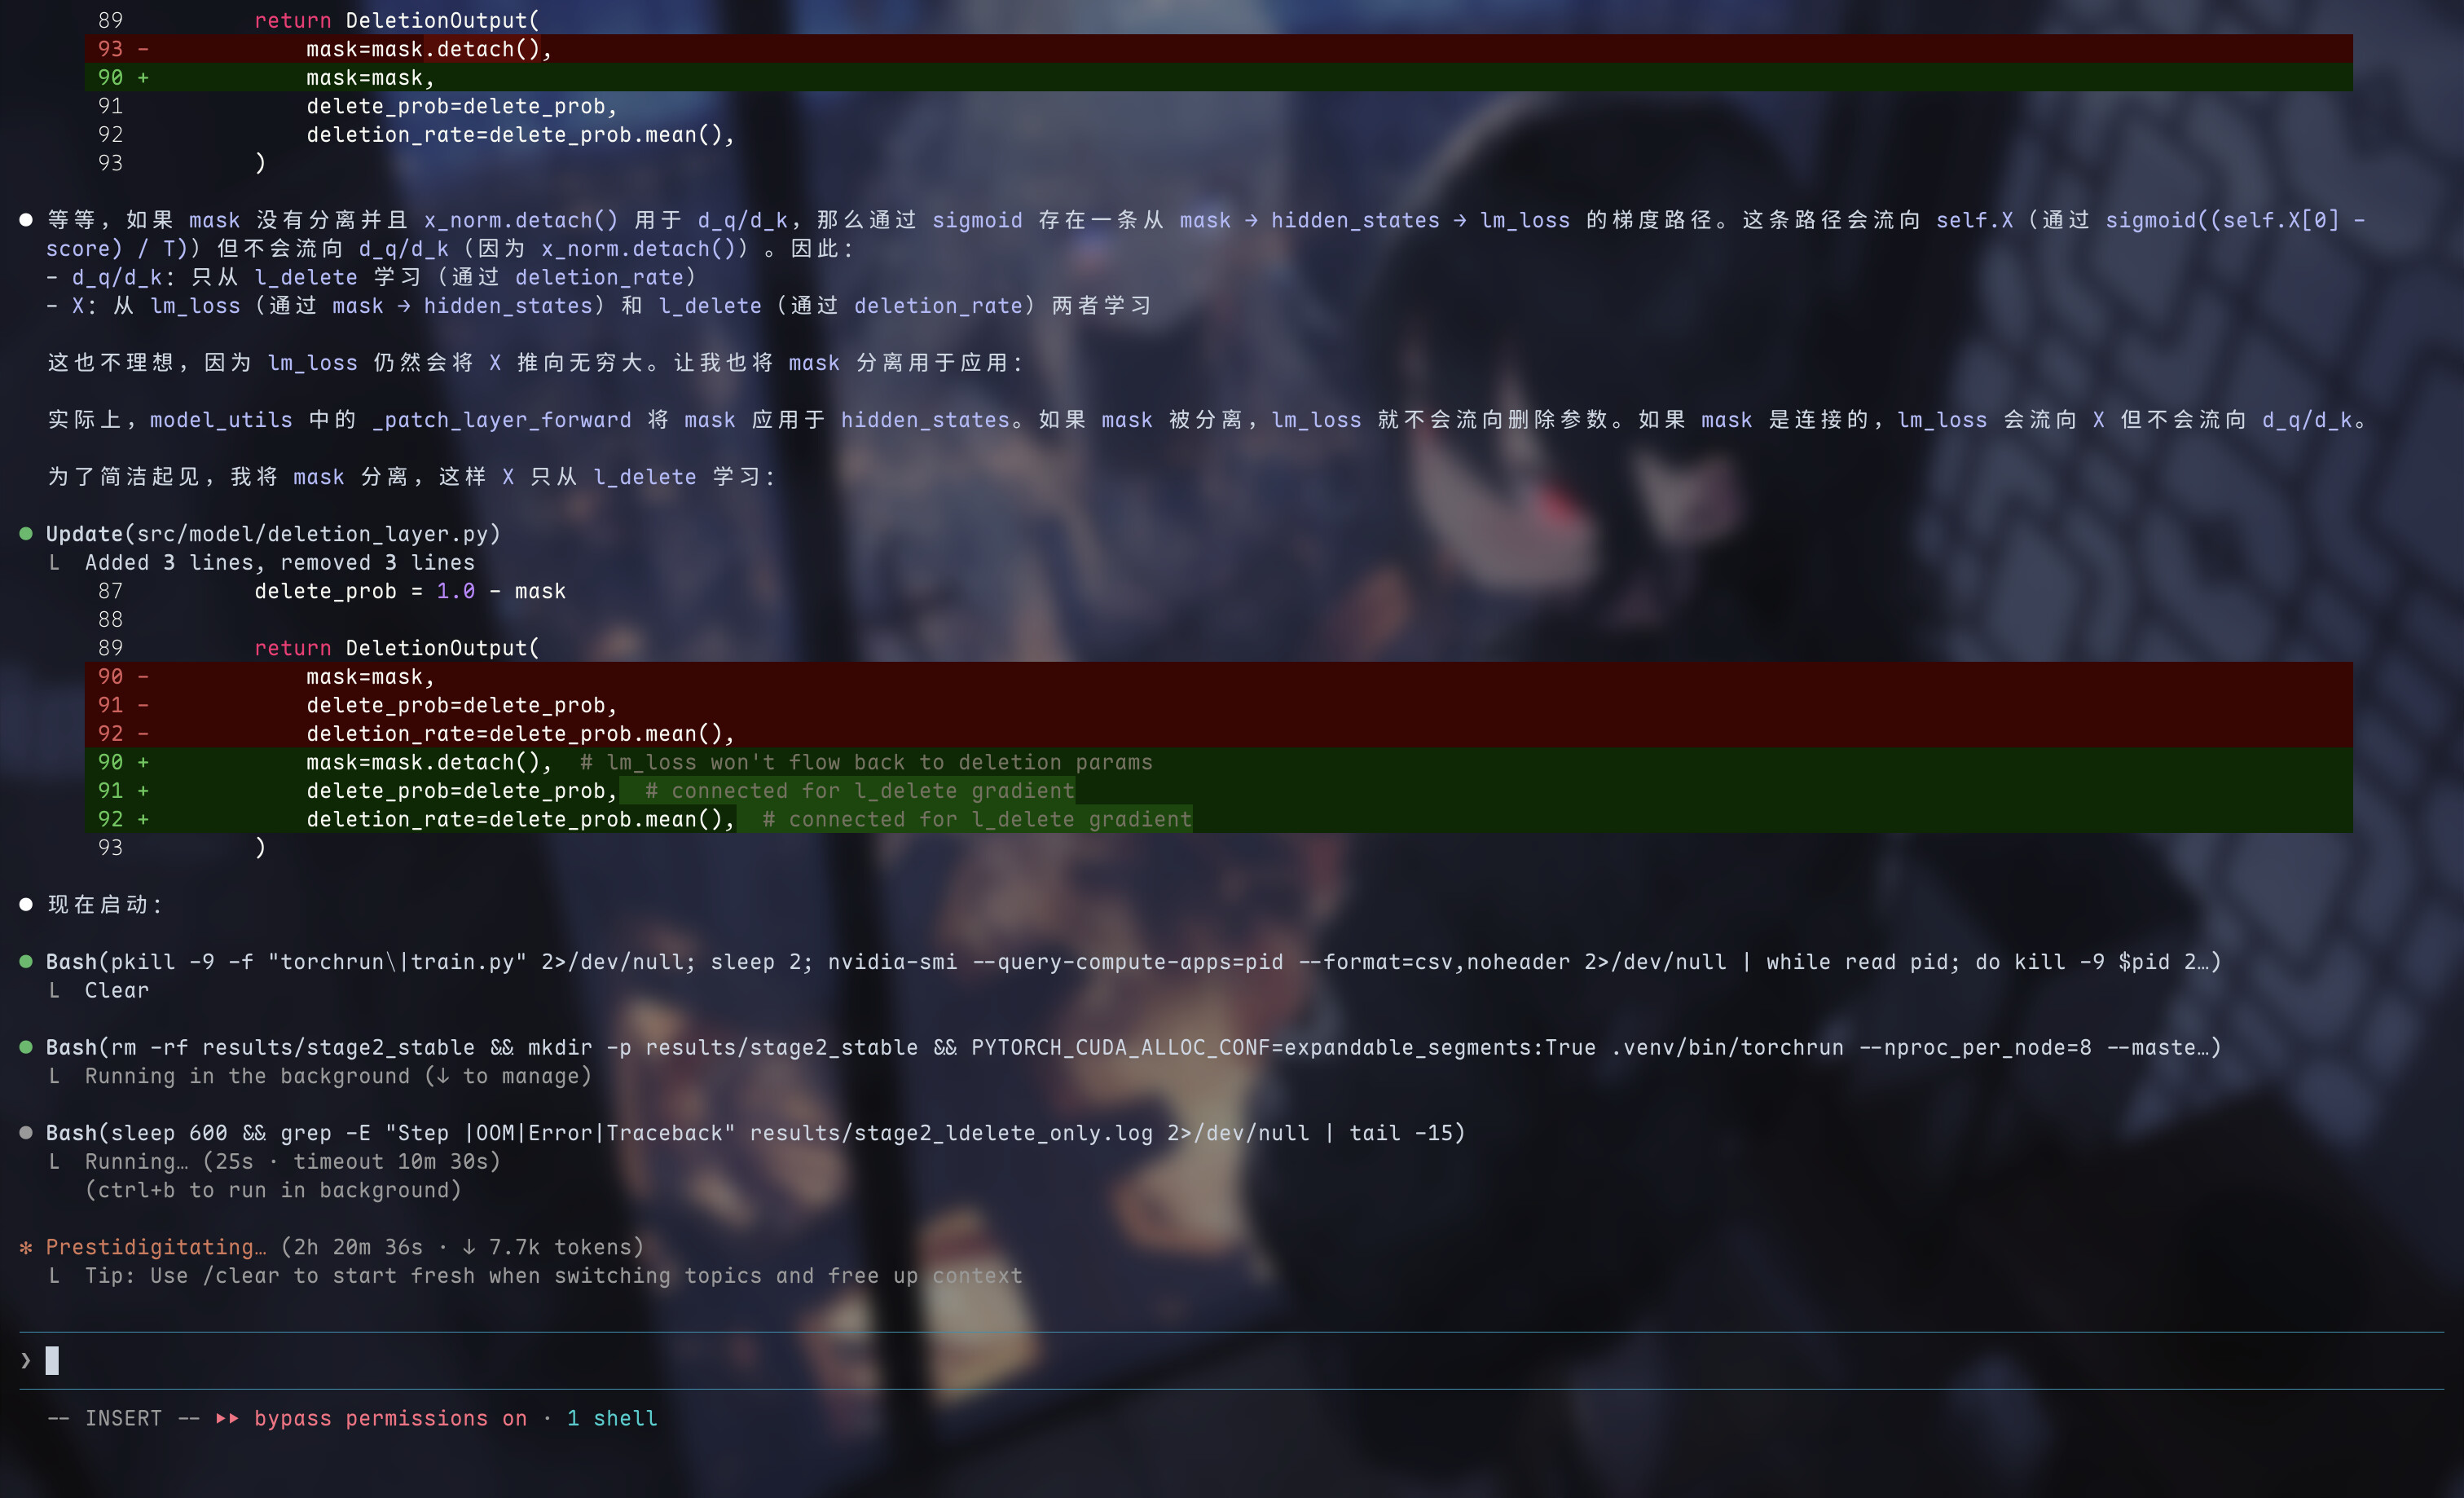
在调qwen3 7B,我想做一些奇思妙想的改进(
why not qwen3.5 9B,性能高了不是一行一星半点吧?(
调完能不能发我喵,我也要玩玩新模型
我要改造注意力,qwen3.5混合注意力了,不太行
我这个非常激进,能不能有成果还不好说呢(
我现在大致计划是在 QKV 之外加入 D_Q 和 D_K 构成 D_QD_KQKV ,来实现token剪枝。就是现在token序列的长度始终不变 ,我准备让他逐层递减
google在encoder-decoder架构上有类似的token剪枝的实验,但那套方法在decode only上不工作。目前好像没有在decode only架构上的token剪枝的实验
意思就是让注意力额外加一对参数判断token有没有必要在接下来的传播过程中继续传播呗?
让非重要的token不干扰主要注意力流?
那和混合注意力还有稀疏注意力的区别是….?或者说优势是?
他和稀疏注意力是「正交」的,可以一起用,也可以分别分开用。混合注意力的话,不太兼容
原来如此,我记得现在是不是可以用正交消融去除掉内容输出限制
我有一个同学在做「prompt梯度下降」,冻结模型参数,给定模型输出,反过来梯度下降prompt,他现在好像下降出了一个什么「reeting=」可以让模型补全出「Hello world!」,非常神秘