少看点吧bro
我们体育老师人挺好,说我们可以不用校园跑那个软件,so我一直用keep,别的班不一定
我觉得keep还挺好用的,就是有的时候感觉记录距离比校园跑软件略少
诶诶诶诶诶?nya居然是受嘛?!我一直感觉nya应该是很攻的大姐姐类型诶(
其实我也觉得嗯嗯
我说我也是受你信吗
針對 https://adult-sex-type-indicator.netlify.app/(ASTI · 澀澀人格測試)的完整前端源碼,我們進行了深入的逆向與算法邏輯分析。
一、 核心結論(TL;DR)
準確程度評定:科學與心理學層面「極低」(純娛樂性質);工程與隱私層面「良好」;但存在顯著的算法缺陷與刻板印象公式。
測試呈現出「看起來很準」的主因是巴納姆效應(Barnum Effect)與細分標籤命中。官方源碼中甚至在註釋與頁面免責聲明中明確寫道:「本測試僅供娛樂……相同選項再次測試可能獲得不同結果」、「所有內容均為 AI 生成……」。
二、 源碼核心架構與計算流程拆解
該網站為一個純前端單頁面(Single Page Application),所有計算均在瀏覽器端使用原生的 JavaScript 完成:
flowchart TD
    A["題庫池 (約 294 題)"] -->|"隨機無放回抽取 85 題<br/>(非分層抽樣,有覆蓋盲區)"| B["用戶回答<br/>(0~4 李克特 5 點量表)"]
    B --> C["計算 10 維度標準分<br/>(D, O, K, R, L, E, F, A, G, T)"]
    C --> D["加權歐幾里得距離匹配<br/>(28 個人格模板原型)"]
    B --> E["標籤累計統計 (tagCounts)<br/>(片型、獵奇偏好、特殊癖好)"]
    C & D & E --> F["生成報告:人格、雷達圖、攻受度、性取向、片型偏好"]
1. 10 個核心維度與 28 個人格原型
代碼定義了 10 個核心維度:
- D (支配傾向)、O (開放程度)、K (獵奇指數)、R (浪漫需求)、L (慾望強度)
- E (表現慾望)、F (幻想傾向)、A (情感依戀)、G (性別彈性)、T (道具興趣)
同時預設了 28 種人格原型(如 PRED 狩獵者, EMPR 帝王/女王, PURE 纯爱战士, DEMO 魅魔体质, ALIEN 异形恋 等)。每個人格都被作者主觀賦予了一個 10 維目標向量 vec。
2. 維度計分算法 (computeScores)
const val = ans - 2; // 選項轉為 -2 ~ +2
scores[n].raw += val * p;
scores[n].weightedRaw += val * p * dimWeight;
scores[n].count += 1;
// 正規化為 0 ~ 100
const frac = s.raw / (s.count * 2);
norm[d.id] = clamp(Math.round((frac + 1) * 50), 0, 100);
3. 人格匹配算法 (matchPersonality)
採用**加權歐幾里得距離(Weighted Euclidean Distance)**在 10 維空間中找最近鄰:
\text{dist} = \sqrt{\sum w_i \times (\text{用戶分}_i - \text{原型分}_i)^2}
誰的距離最小,就判定為該人格。
三、 為什麼「準確度」不高?(關鍵源碼硬傷分析)
1. 致命缺陷:抽題非「分層抽樣」,導致重測信度(Reliability)極差
- 題庫分佈極度傾斜:題庫約有 294 題,其中「獵奇 K」相關的題目(異種、重口、BDSM)佔了近百題,而「慾望強度 L」和「表現慾 E」只有各 14 題。
- 隨機抽取 85 題(
shuffle().slice(0, 85)):
因為不是依據各維度配額抽樣,低頻維度極容易抽到極少題(甚至 1~2 題)。若用戶剛好有 1 題選極端,該維度就會暴增或暴跌;如果某維度沒被抽到,代碼直接默認賦值50分。
這導致同一個人以完全相同的心態測兩次,雷達圖與最終人格可能完全不同。
2. 公式存在主觀與刻板印象偏見(以「攻受度」為例)
在 deriveAnalyses 函數中,攻受比例計算公式如下:
let atkPct = Math.round(dScore * 0.65 + (100 - gScore) * 0.15 + (100 - aScore) * 0.2);
這段代碼的邏輯反映了作者高度主觀的假設:
dScore * 0.65:支配慾越強越偏攻(尚合直覺)。(100 - gScore) * 0.15:性別彈性越低(越傳統異性戀)越偏攻,性別流動/同性傾向越高越偏受(純屬無科學依據的刻板印象)。(100 - aScore) * 0.2:越不容易走心、抽離冷酷的人越偏攻,越重視情感依戀的人越偏受(影視標籤化思維)。
3. 性取向推斷過於粗暴
代碼將「性別彈性 G」維度直接切檔判定性取向:
- G \ge 80 \to 泛性戀
- G \ge 60 \to 雙性戀
- G < 40 \to 異性戀為主
但 G 維度的題目混雜了「是否喜歡男娘/假小子」、「是否質疑性別二元論」和「是否對同性有性吸引」。喜歡二次元男娘在性學上常歸於異性戀男性範疇,但在此測驗中會直接拉高 G 分數,可能導致用戶被直接歸類為雙性/泛性戀。
4. 片型偏好與癖好模組:基於標籤計數(過度依賴隨機抽題)
if ((tagCounts['pov'] || 0) > 1) ... // 第一人稱 POV
if ((tagCounts['face'] || 0) > 1) ... // 重視顏藝
if ((tagCounts['bdsm'] || 0) > 2) ... // 判定 BDSM
因為片型相關題目總共才 24 題,在 85 題中隨機抽中 pov 且被你選到 \ge 2 次的機率不高。這導致「片型觀看偏好」模組經常因沒抽中對應題目而得出「各類題材皆能接受」的泛化結論。
5. 廢代碼與算法粗糙
- 在
computeScores中計算了scores[n].weightedRaw += val * p * dimWeight,但在最後正規化時用的卻是s.raw / (s.count * 2),維度權重dimWeight在維度分計算中實際上被完全忽略。 - 部分題目的極性為
0.5(如輕微相關),但正規化分母固定除以s.count * 2,導致包含 0.5 的維度在數學上永遠無法達到 100 分。
四、 亮點與工程優點
- 隱私安全性極佳(100% 離線運行):
代碼沒有任何後端傳輸、沒有埋點分析、沒有第三方 API 上報,所有回答和報告均在使用者瀏覽器內暫存,關閉即丟失。 - 性癖題庫覆蓋細緻廣泛:
題庫大量收錄了 BDSM、Pet Play、CNC、觸手、福瑞(Furry)、扶她(Futa)、異種戀(Xenophile)、情趣玩具開發等次文化性取向,對特定圈子(如二次元/小眾性癖好者)而言,具有極高自嘲與同好交流價值。 - UI 與視覺化體驗良好:
內置 Canvas 繪製 10 維度雷達圖,交互平滑,適合社群截圖傳播。
五、 總結評分
| 維度 | 評分 | 說明 |
|---|---|---|
| 心理測量學嚴謹度 | ★☆☆☆☆ (1/5) | 缺乏因子分析、無常模對比、無重測信度檢驗,純作者經驗主義。 |
| 重測穩定性 | ★★☆☆☆ (2/5) | 85/294 題非分層隨機抽樣,不同次測驗波動極大。 |
| 隱私與安全性 | ★★★★★ (5/5) | 純前端運算,零數據外洩風險。 |
| 社交娛樂價值 | ★★★★☆ (4/5) | 人格設定有趣、雷達圖吸睛、標籤直白,適合作為同好間的破冰談資。 |
这是好事啊
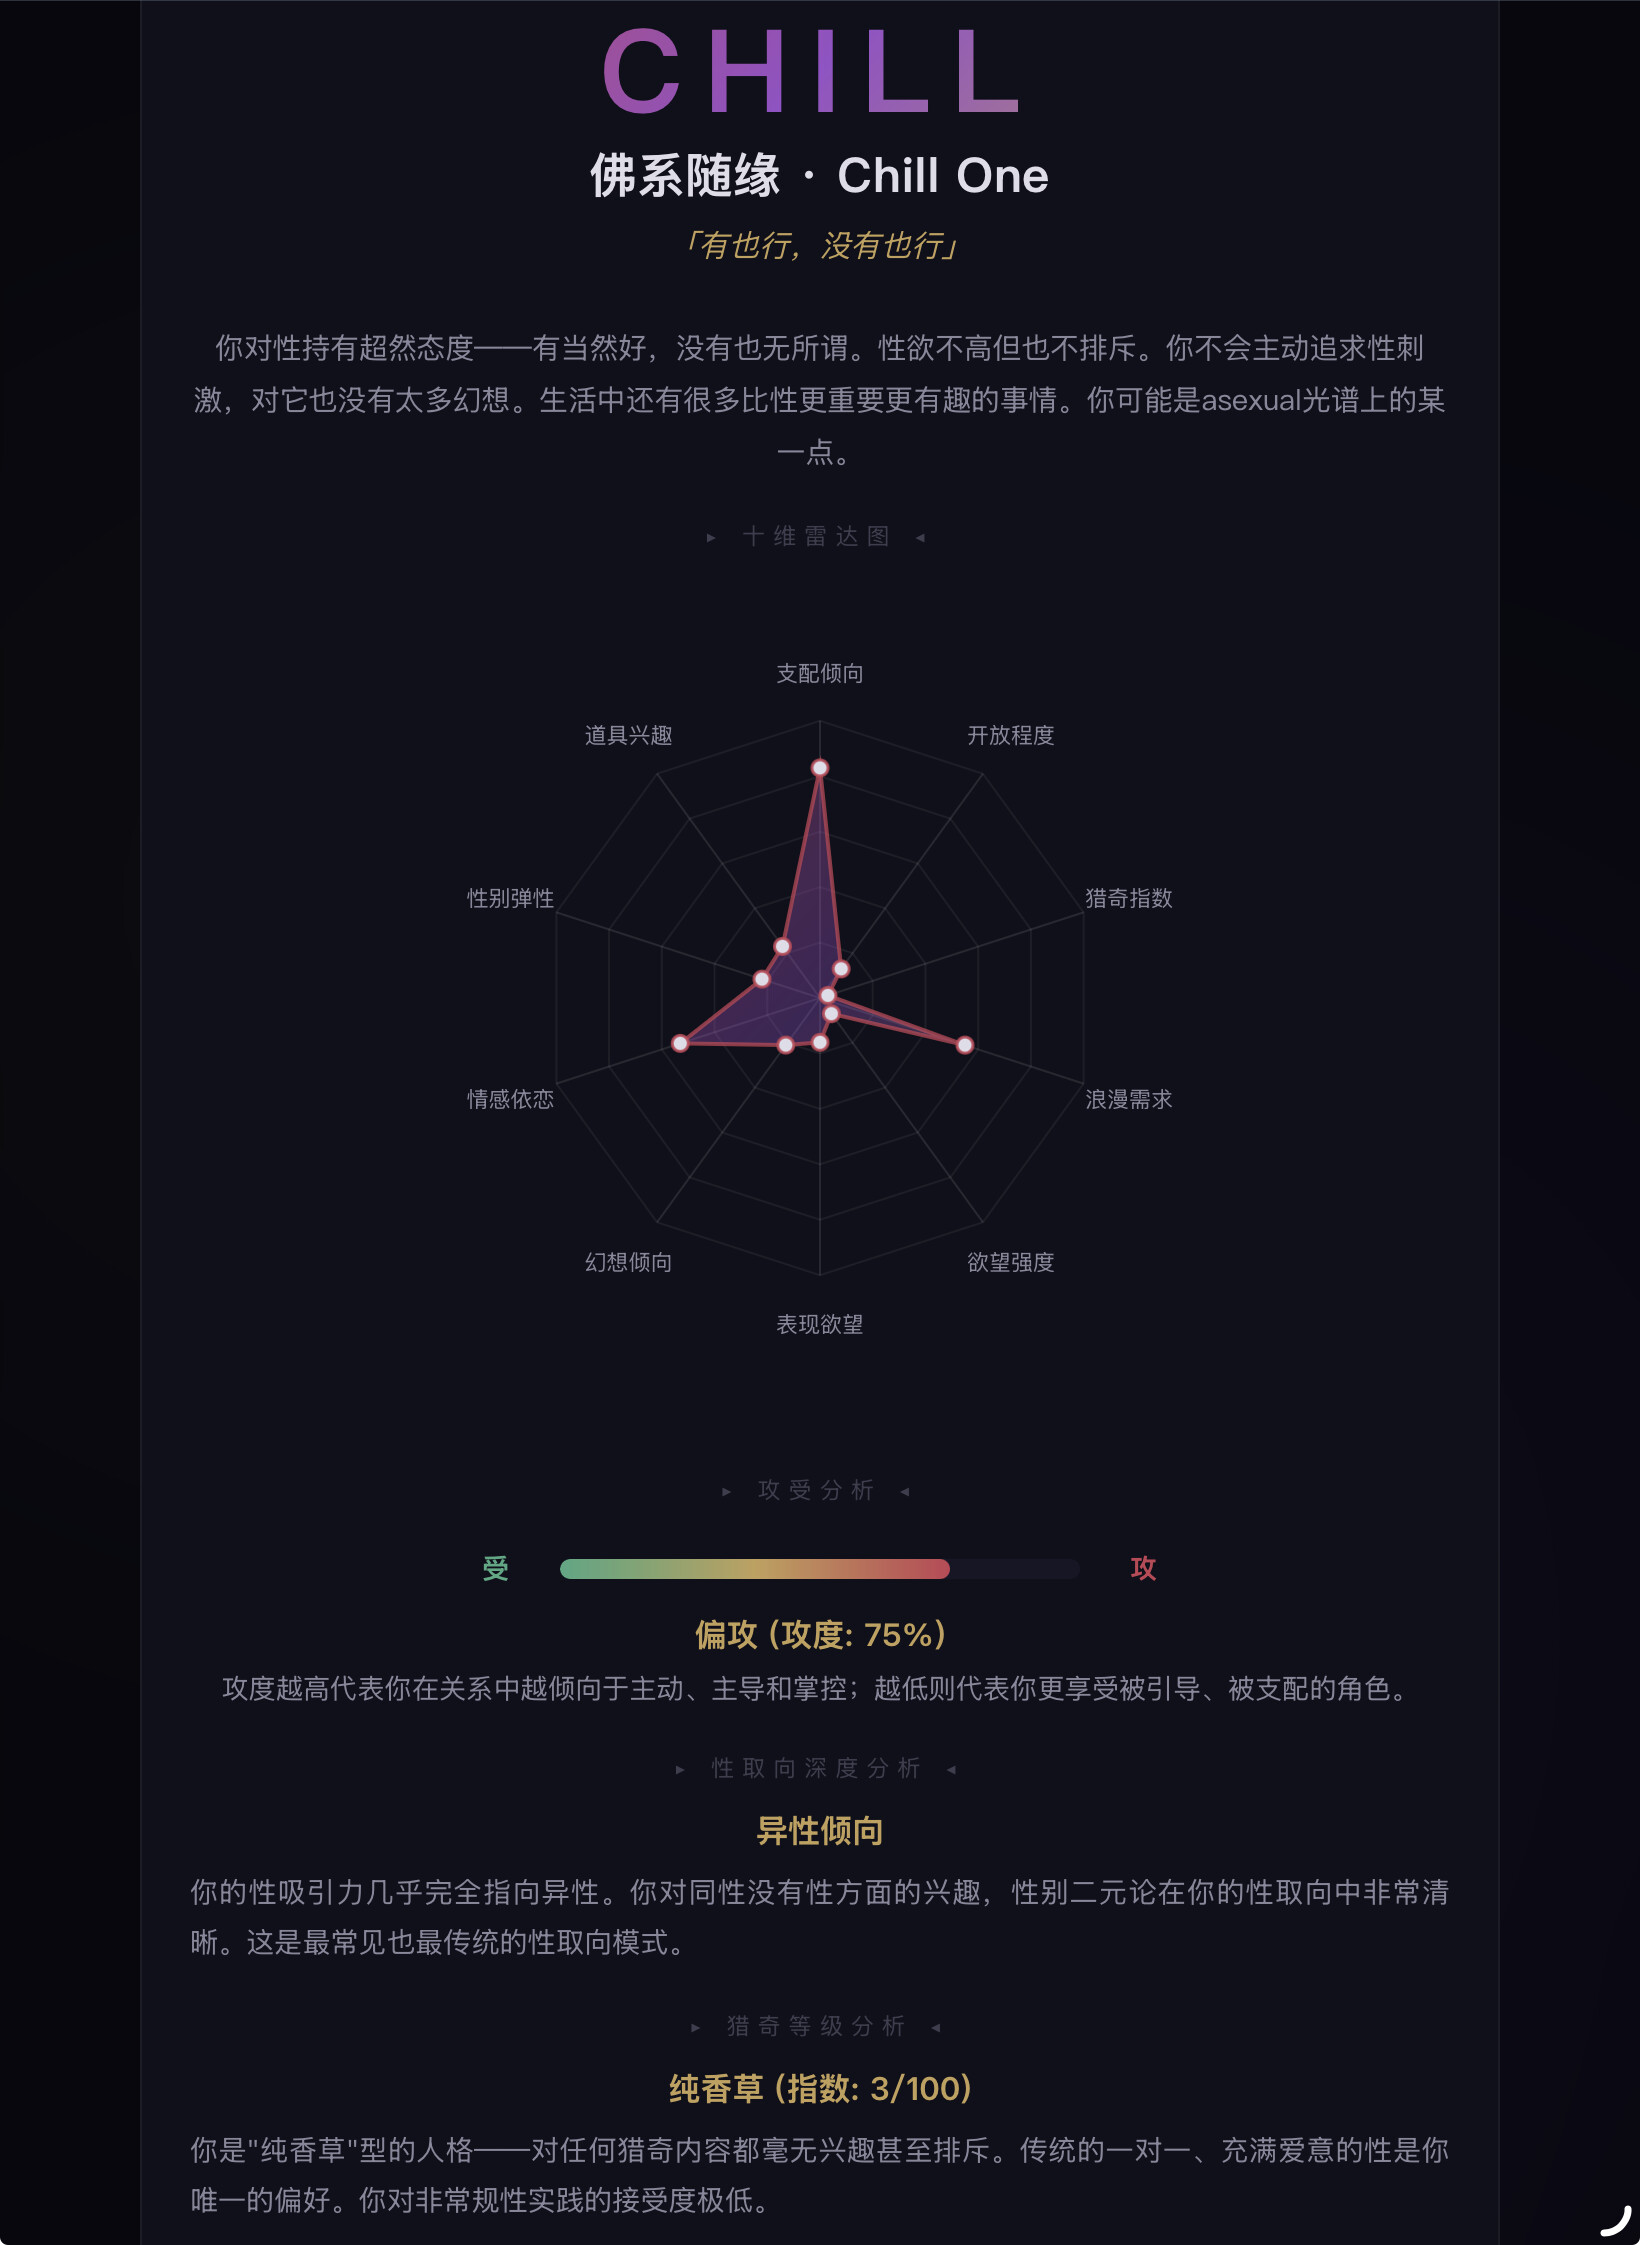
还真是科学性为零娱乐性拉满
怎么变成?!攻攻!?了
可能最近“杀杀杀杀杀杀杀”太多了罢(
等我更新一版稍微有點準確性的⋯⋯
蹲蹲蹲
(笋苗居然会出这种么,认知重塑中…
啟用一個新帳號註冊netlify,一分鐘,網站搭建,三分鐘⋯⋯
主要是原網站信度⋯⋯ 太低了,不能接受⋯⋯
補一句,我最不能接受的是原網站選擇完還要自己點下一道⋯⋯
强迫症笋苗 
都是借口…
行,我是switch行了吧
我很攻吗我靠,不行了够我得瑟好久了
真有那味
我这个身高也攻得起来吗…比笋苗还矮