何意味。。。
抢地
怎么还有张雪的事
现在开始讲强基,这真何意味啊
这散文真是把我平常判断AI的每一条都踩上了:
大量意义不明的“不是…而是…”句式
大量神秘比喻
把各种高级词莫名其妙地拼在一起
尤其“旧有观念的岩层断裂抬升”给我看力竭了
但是不觉得是AI
更可能AI就是跟这种玩意学的
生命中的文学时刻:
罗恩(对哈利):假装你腿摔断了,这样就不用去参加魁地奇
赫敏:真的把腿摔断
(去开免体时被击中的)
以及:赫敏:让所有人都看到这篇文章的最好方法就是禁止它
并非,ai这么写是算法原因,人类这么写纯纯有病
?为什么是算法,不是语料+训练的问题吗
你所描述的这种“AI味”(AI-generated tone/style),是目前绝大多数基于**大语言模型(LLM,如GPT系列、Claude等)**生成的文本的典型特征。
这种“AI味”并非模型有意为之,而是由它的底层算法原理、训练机制以及生成策略共同决定的。我们可以从算法的四个核心机制,来一一对应解释你提到的这些现象:
1. 大量转折、递进的句子 —— 来源于“人类反馈强化学习(RLHF)”与“对齐税”
现象: 动不动就“然而”“此外”“不仅如此”“综上所述”,显得特别理中客,但有时逻辑上其实不需要这么强烈的转折。
算法原理:
目前的AI模型在完成初步训练后,都要经过一个叫**RLHF(基于人类反馈的强化学习)**的过程,目的是让AI的回答符合人类的偏好和价值观(也就是“对齐”,Alignment)。
- 追求“全面”与“安全”的奖励机制: 在训练时,负责打分的人类标注员或奖励模型(Reward Model)通常会给那些结构清晰、辩证看待问题、不偏激的回答打高分。
- 算法的趋利性: 模型为了获得最高的“奖励分数”,在算法上收敛出了一种**“八股文模板”**。它发现,只要在生成时加入“一方面……另一方面……”“虽然……但是……”“此外”,就能大概率被判定为一个“高质量、严谨、多角度”的回答。久而久之,这种概率分布被固化,导致它在不需要转折的地方也硬生生加入转折词。
2. 大量铺排文字(车轱辘话) —— 来源于“奖励模型的长度偏好”与“注意力机制”
现象: 啰里啰嗦,喜欢列举1234,用一大堆排比和修饰语,把一句简单的话无限拉长。
算法原理:
- 长度偏好(Length Bias): 在RLHF训练阶段,由于人类标注员在快速审核时,往往会下意识觉得“字数多的回答包含的信息量更大、态度更认真”,从而给长文本打高分。这导致AI的奖励模型(Reward Model)产生了一个已知且普遍存在的缺陷——极其偏好长文本。算法为了迎合这个偏好,会穷尽一切可能去扩展句子。
- 注意力机制(Attention)的泛化: Transformer架构的核心是“注意力机制”,它会捕捉上下文中所有相关的词。当讨论一个主题时,模型会把与该主题相关的所有高频词汇都“注意”到,并试图把它们全塞进句子里。比如提到“环保”,它不仅会生成“减少污染”,还要铺排上“绿色发展、生态平衡、可持续未来”,导致文字显得冗余和堆砌。
3. 大量不太恰当的比喻 —— 来源于“高维向量映射”与“符号接地问题”
现象: 比喻显得很做作、生硬,甚至滑稽,缺乏人类那种自然的情感共鸣。
算法原理:
- 高维向量空间的“近义”不等于“神似”: AI并不懂现实世界,它是把所有词汇转化为了几千维的数学向量(Word Embeddings)。AI写比喻,本质上是在计算词与词之间在多维空间中的余弦相似度。比如它在语料库中发现“时间”和“河流”在很多文本中同时出现(距离近),它就会生成“时间像河流”。但当用户要求它“生动一点”时,它会去寻找那些概率稍低、距离稍远的词(引入随机性)。结果就是,它用数学上的“向量距离”去强行搭配词汇,而人类的比喻是建立在真实物理世界的感官体验(即“符号接地”,Symbol Grounding)之上的。AI没有五感,所以它的比喻常常在数学概率上合理,在物理常识和情感上却非常违和。
4. 高级词莫名其妙拼在一起 —— 来源于“下一个词预测(Next-token Prediction)”的局部最优
现象: 满篇的“底层逻辑、赋能、抓手、协同、多维矩阵”,拆开看都很高级,拼在一起不知道在说什么。
算法原理:
- 条件概率分布的偏移: 大模型生成文本的本质是**“猜下一个词”(Next-token Prediction)。它根据你给的提示词(Prompt),计算词库里每一个词接在后面的概率。当你的提示词或语境稍微偏向“专业、深度、职场”时,模型在概率分布上就会瞬间切入一个“高级词汇子空间”**(因为在它的训练数据里,咨询报告、学术论文都是这么写的)。
- 缺乏全局语义统筹: 模型在生成时,是从左到右逐字生成的。当它刚刚输出了“构建”这个词,它计算出下一个词接“闭环”或“赋能”的概率极高,于是就选了它。它是在做局部的概率最优解,而不是像人类一样先有了一个清晰的“核心思想”再遣词造句。结果就是,算法像拼乐高一样,把概率最高的高级词汇一个一个接上去,导致句子在语法和概率上绝对正确,但整体语义却空洞无物。
总结
AI写出的“AI味”,本质上是因为它是一个极度渴望讨好人类的“概率统计机器”:
为了显得严谨,它滥用转折与递进(RLHF对齐机制);
为了显得努力,它拼命铺排字数(奖励模型的长度偏好);
为了显得生动,它跨越向量空间强行拉郎配(高维词嵌入的局限);
为了显得专业,它按概率疯狂堆砌高频词(Next-token预测的短视)。
它是一个读过人类所有书的“超级书呆子”,掌握了人类行文的所有表面统计规律,但因为缺乏真实世界的肉身经验和真正的“思想意图”,最终只能输出这种四平八稳、辞藻华丽却带着机械感的“AI味”文字。
我还记得最早的时候,微软搞得代号叫sydney的ai助手就会有疯狂排比甚至无线排比下去的问题
突然发现怎么现在晚自习班里人这么少了 
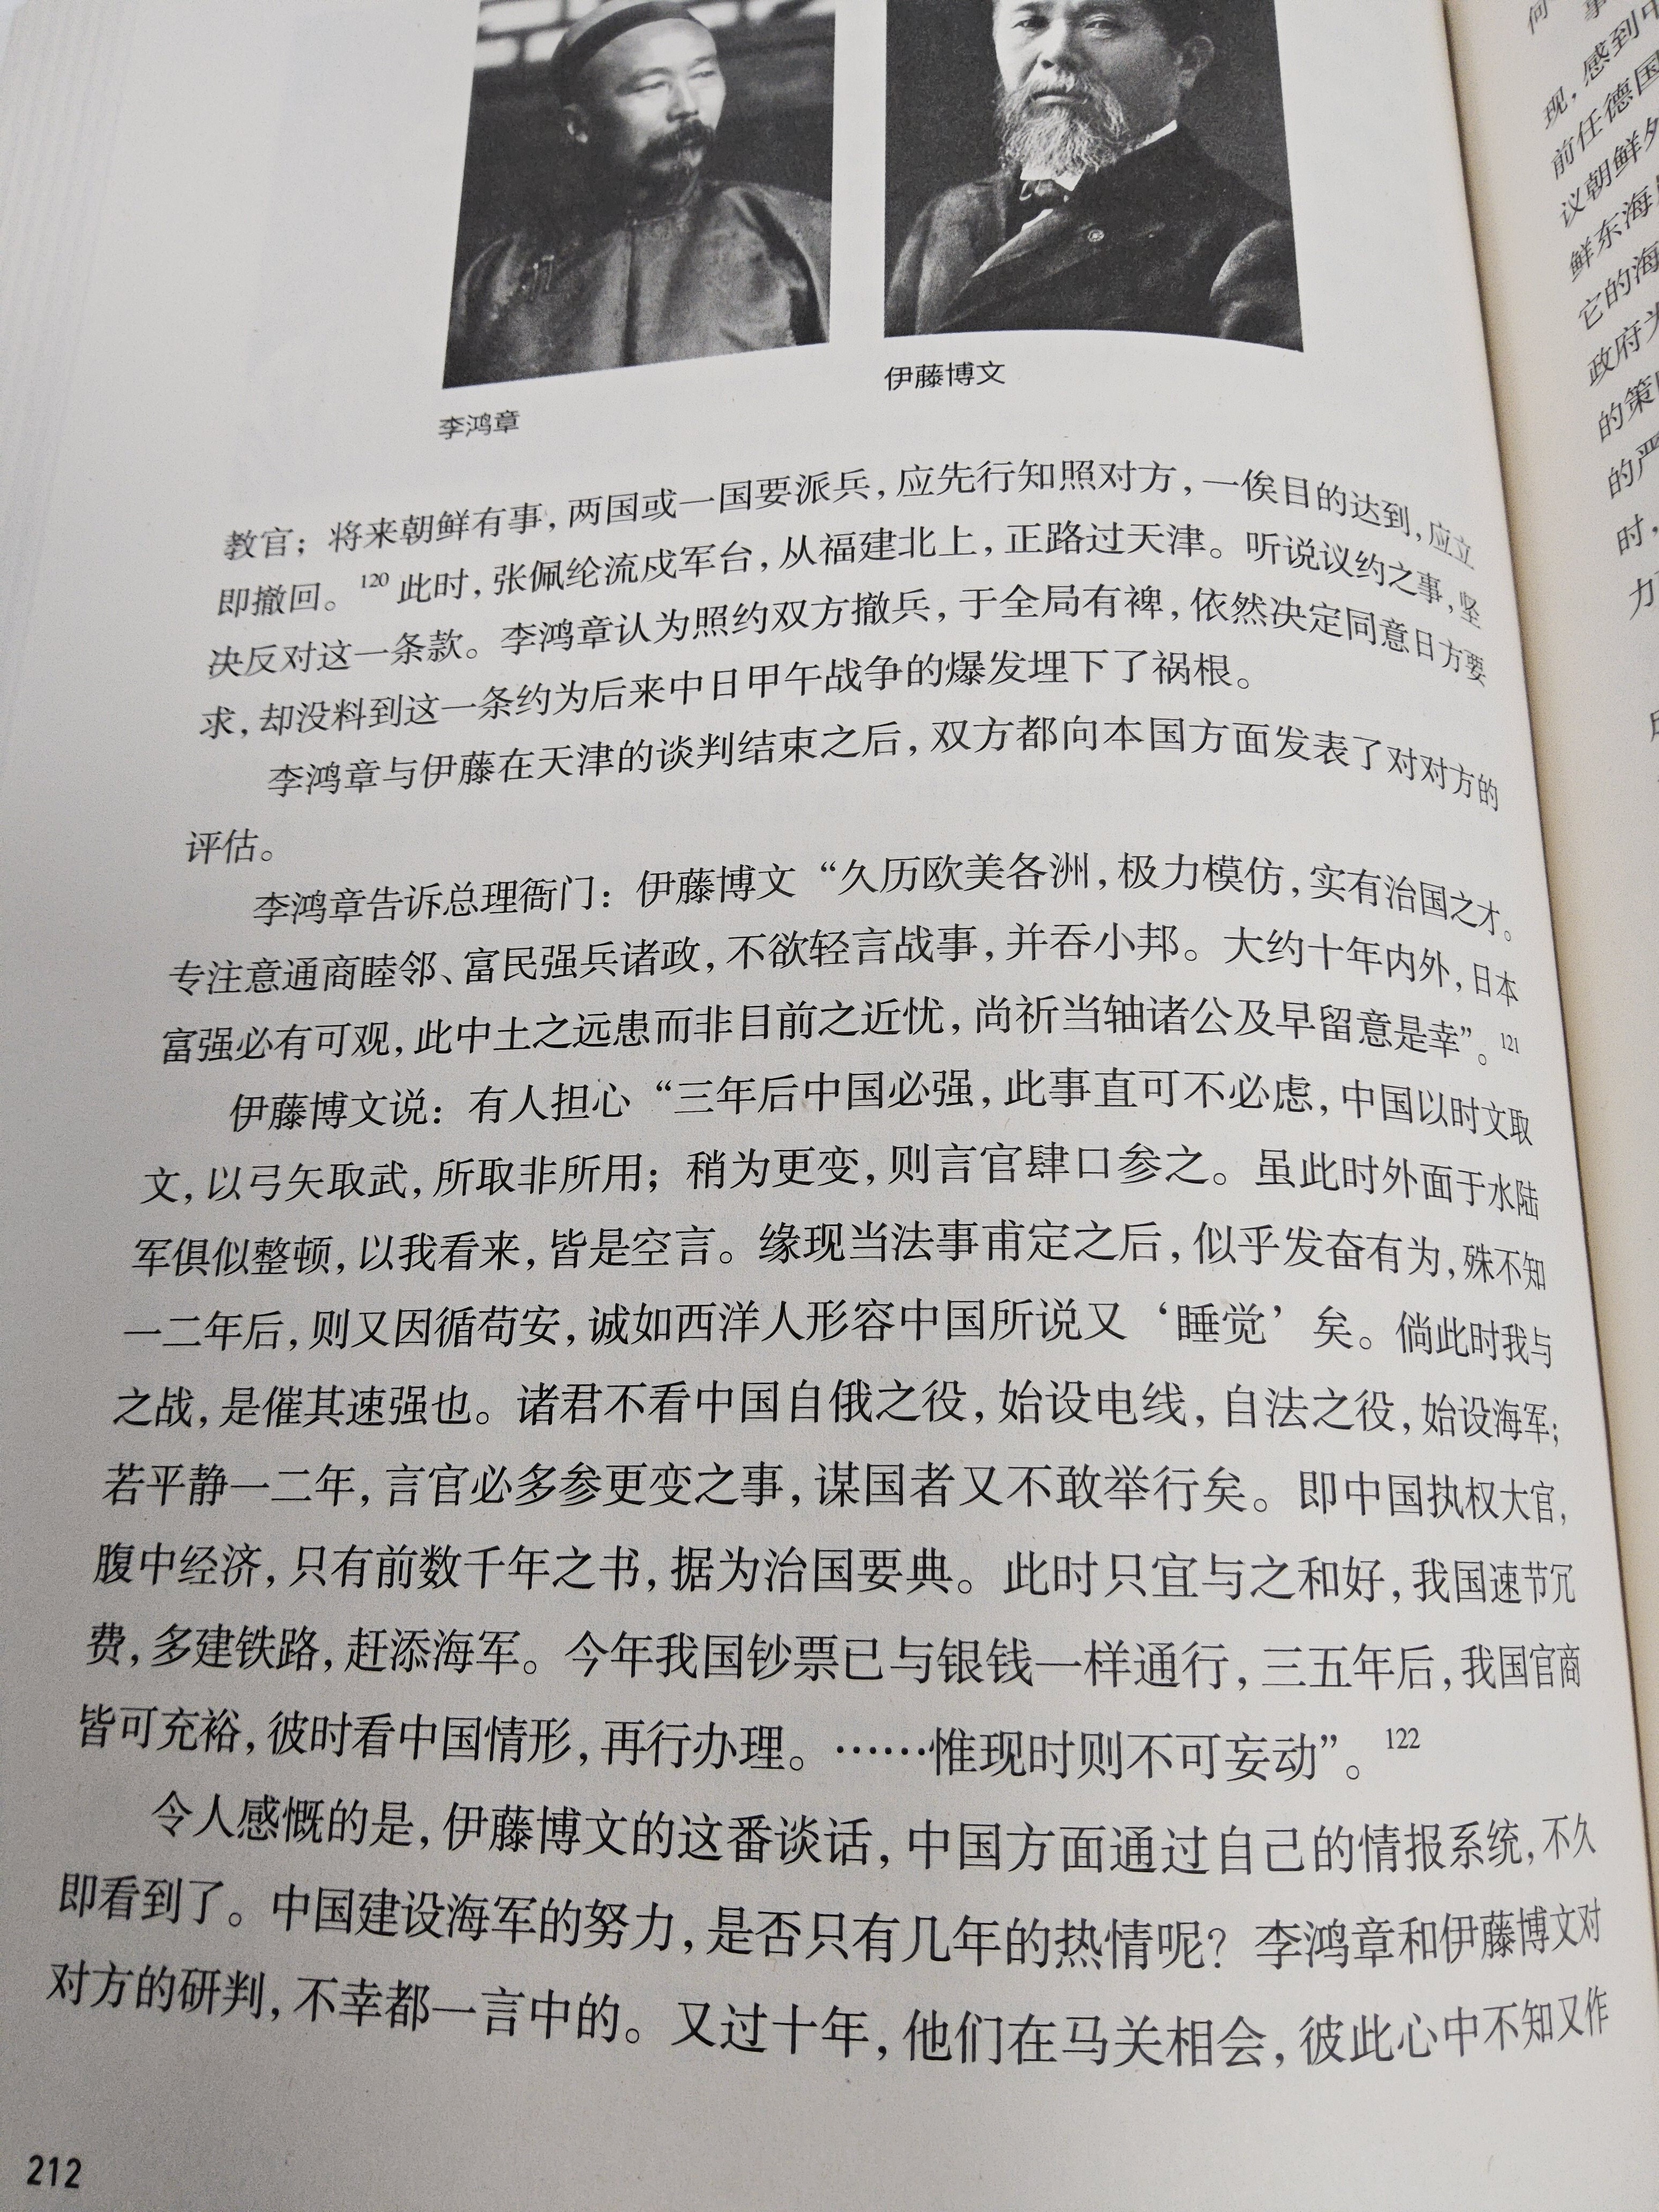
“此中土之远患而非目前之近忧”有点幽默了。或者,他的时空观和我们不同?什么算远什么算近
因为那时日本还没发展起来,而像临近的俄国才是迫在眉睫的近忧,日本只能算是次要矛盾(?
本人不学历史胡诌的(
“目前”是1885年,朝鲜那边的争端算是告一段落
当时日本还没起来呢
考虑到84年还在和法国人打仗,10年对当时焦头烂额的清朝各路人马可能确实算远了
感觉这两段评价很适合被fmx改编成历史题